AI可见度监测提示词怎么抽样?先分层,再固定样本与计算分母
作者:若凡(Devin) · 发布于 · 更新于
AI可见度监测提示词应采用分层抽样:先按产品线、用户任务、漏斗阶段、品牌与非品牌、地区和语言建立样本框,再给关键层分配配额。样本发布后冻结文本和测试条件,提及率、官网引用率与准确率各自写清分母,才能比较不同周期。
GEO提示词地图保存完整问题宇宙,抽样只选能代表业务并可长期复测的部分。AI可见度监测报告不能用临时补问的有利问题替换固定样本。
先建立样本框,不从工具推荐直接开跑
样本框来自销售、客服、站内搜索、Search Console、招标资料和客户访谈。每条问题记录产品、角色、阶段、任务、市场、语言、品牌属性和来源。工具推荐可补候选,但不能决定业务权重。
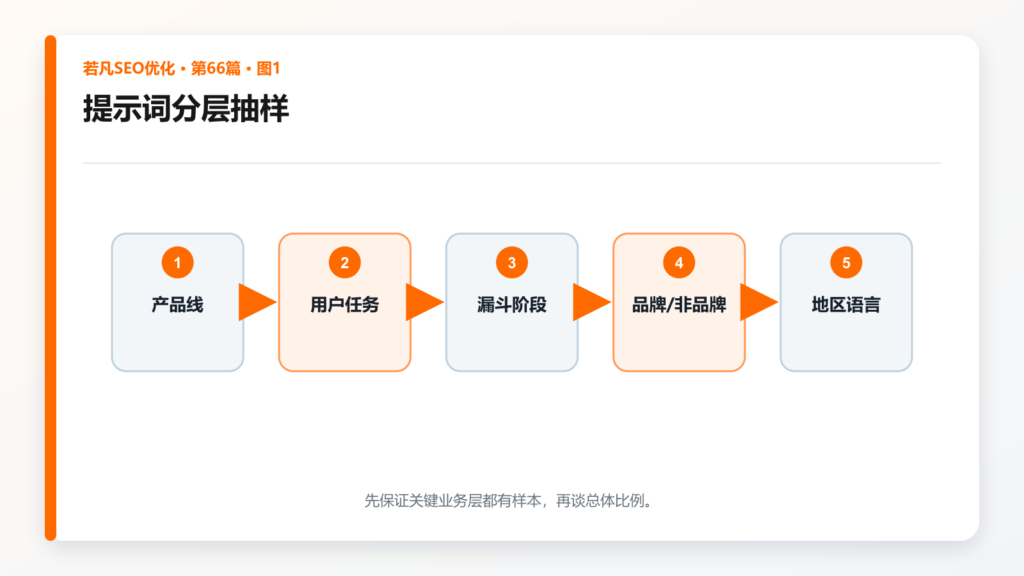
图1:先保证关键业务层都有样本,再谈总体比例。
给关键层分配最低配额
样本量有限时,先保证核心产品、非品牌发现、方案比较、风险核验和主要市场都有题。品牌问题过多会高估可见度;只问泛品类又可能忽略事实纠错。
可以采用40%发现与比较、30%任务执行、20%信任核验、10%售后风险的起始配额,再按业务调整。数字是规划示例,不是行业标准。
用一张表固定分母
| 指标 | 分子 | 分母 | 排除项 |
|---|---|---|---|
| AI功能触发率 | 触发回答题数 | 全部有效题 | 平台故障 |
| 品牌提及率 | 提及品牌题数 | 适合出现品牌且触发题 | 纯知识题 |
| 官网引用率 | 展示官网链接题数 | 触发且有可见来源题 | 无来源答案 |
| 事实准确率 | 核心事实准确题数 | 提及品牌题数 | 无品牌题 |
| 推荐语境率 | 推荐品牌题数 | 适合推荐且触发题 | 强制品牌题 |
| 首轮样本 | 至少50题 | 分层后的有效题 | 故障与失效题 |
同一指标跨周期必须沿用相同分母,否则数值变化无法解释。
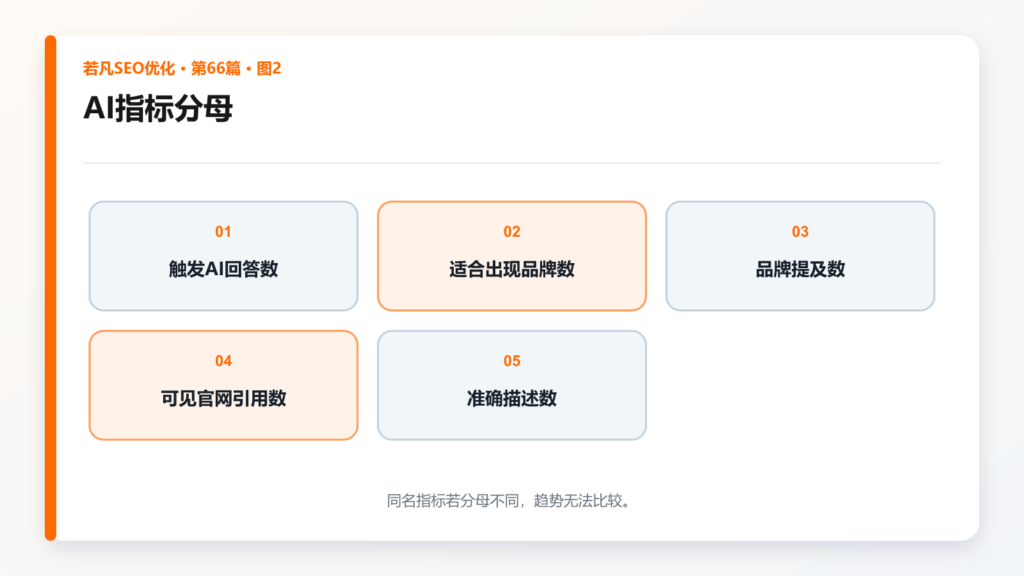
图2:同名指标若分母不同,趋势无法比较。
控制平台、地点与运行成本
Ahrefs说明,一次检查通常按提示词×平台×地点计量;更高频率会消耗更多检查额度。Semrush工具也有默认提示词限制。应先覆盖关键组合,不要把所有问题跑遍所有平台和国家。
保留重复运行与波动记录
同一问题可在预先约定的日期窗口运行2—3次,全部保留,不挑最好答案。报告同时给出题级结果和汇总比例;平台未触发、超时或答案不可用单独标记,不默认为“未提及”。
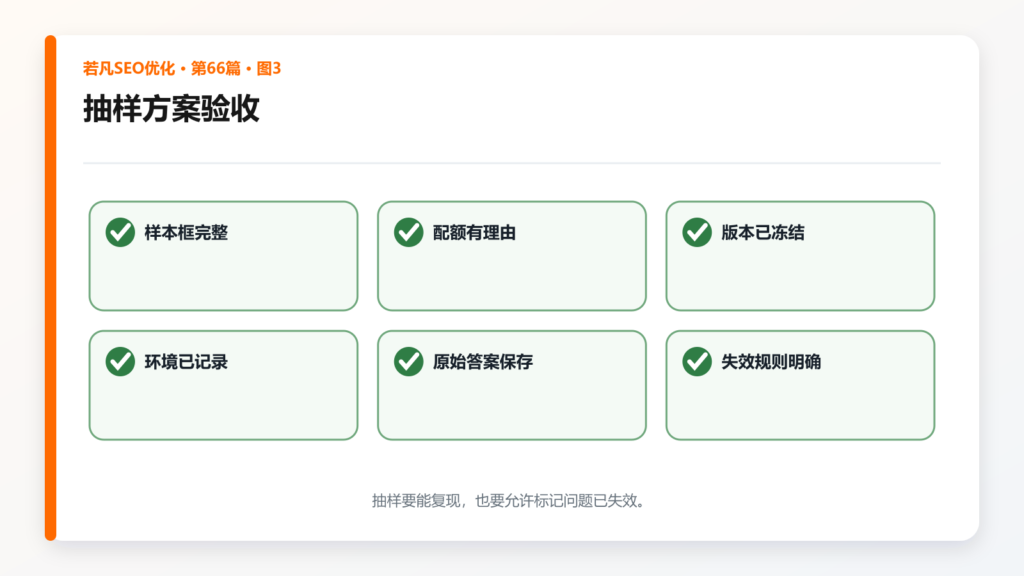
图3:抽样要能复现,也要允许标记问题已失效。
设置样本替换规则
产品停产、市场退出或问题不再真实时标记失效,保留历史版本;新增题进入下一版基线。每季度审查样本结构,但不要每周随答案改问题。GEO优化服务需要把版本变更写进月报。
替换题要记录旧ID、失效原因、新ID和生效周期;跨版本趋势同时展示共同样本与全量样本,防止仅因题目更换造成比例上升。每次发布前由业务负责人确认样本仍代表真实客户。
最终交付包括样本框、抽样配额、固定问题、平台环境、指标字典、原始答案和版本记录。汇总后由SEO数据分析把AI结果与引荐访问、询盘分开呈现。
FAQ
监测提示词越多越准确吗?
不一定。样本结构、任务代表性和测试条件比单纯数量更重要。
可以只监测品牌词吗?
可以用于品牌事实纠错,但不能代表非品牌发现和推荐可见度,应明确报告范围。
一个提示词要跑几次?
可预先约定2—3次观察波动;所有结果都要保留,不能只取最有利的一次。
平台没有触发AI回答算未提及吗?
不应直接合并。应单列未触发、故障和未提及,分别计算。
多久替换一次提示词?
季度审查较常见;只有业务任务失效时替换,并用新版本重新建立基线。
按月复测 ChatGPT、Perplexity 与 AI Overviews 品牌提及率。
免费获取 CSV 模板 →