新网站上线后如何让Google尽快发现和收录?最有效的做法不是反复“提交网址”,而是先确认页面可公开访问、返回 200、没有被 robots.txt 或 noindex 误拦,再用 Google Search Console 验证网站、提交只含规范网址的 Sitemap,并为首页和核心页面建立可抓取的内部链接。URL 检查可以提醒 Google 抓取少量重点页面,但不能保证立刻收录。
这份清单适合刚上线的外贸独立站、B2B 官网和跨境电商站。它解决的是“让 Google 发现并判断页面是否具备收录条件”,不承诺排名,也不把“已抓取”误写成“已收录”。
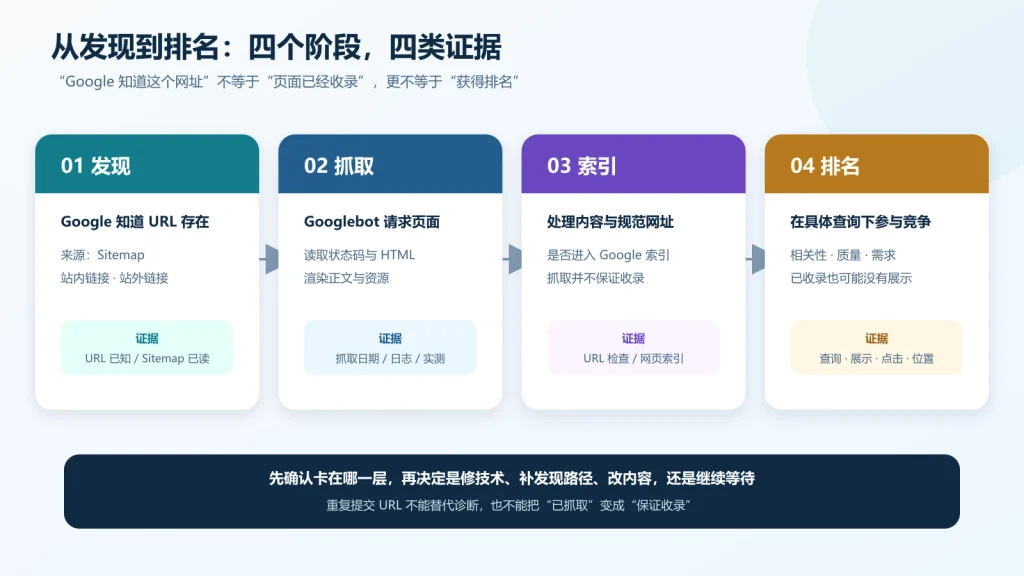
先分清:被发现、被抓取、被收录不是同一件事
很多新站的判断从第一步就错了:在 Google 搜不到品牌名,便认定“蜘蛛没来”。实际上,页面可能已被发现但还没抓取,也可能已经抓取却没有进入索引。
- 发现(discovery):Google 已经知道这个 URL 存在,来源可能是 Sitemap、站内链接或站外链接。
- 抓取(crawling):Googlebot 请求页面并读取返回内容。
- 收录(indexing):Google 对内容、规范网址和其他信号做处理后,决定是否把页面纳入索引。
- 排名(ranking):已收录页面在具体查询下是否展示、展示在什么位置,是下一阶段的问题。
Google 公布的最低技术条件只有三类:Googlebot 没有被阻止、页面返回 HTTP 200、页面含有可索引内容。但官方也明确说明,满足条件只代表“有资格”,并不保证一定收录。可直接对照 Google 搜索技术要求。
第 1 步:先清掉会让整站失去收录资格的设置
提交 Sitemap 之前,先用无痕窗口和抓取工具检查核心页面。若首页、产品分类页或服务页仍需要登录、只对内部 IP 开放,Googlebot 也看不到它们。
页面必须公开、稳定并返回正确状态码
核心页面应直接返回 200。不要让正式网址先跳到测试域名,也不要用一个内容很少的“网站建设中”页面代替真实内容。页面看起来正常但服务器返回 404,或正文只有错误提示,可能被判断为 soft 404。
robots.txt 和 noindex 要分别检查
robots.txt 管的是抓取,noindex 管的是索引。一个常见上线事故是:测试环境为了防止曝光而设置了全站 noindex 或 Disallow: /,上线时忘了撤销。
需要收录的页面应同时满足:
robots.txt没有阻止 Googlebot 请求;- HTML 的 robots meta 或响应头没有
noindex; - 页面不要求登录,也没有被防火墙、CDN 规则或地区限制误拦。
不要用 robots.txt 代替 noindex。如果 Google 无法抓取页面,它也看不到页面里的 noindex 指令。Google 的 noindex 官方说明 对这一区别有明确解释。需要逐项排查时,可参考站内的 robots.txt 设置说明 和 技术 SEO 诊断范围。
规范网址必须指向最终正式版本
确认 HTTPS、www 或非 www、尾斜杠规则已经统一。每个核心页面的 rel="canonical" 应指向你真正希望收录的最终网址;Sitemap、站内链接和 301 重定向也应使用同一个版本。Canonical 是信号,不是强制命令,Google 仍可能选择另一个页面作为规范网址,详见 Google 规范化说明。
第 2 步:在 Google Search Console 验证完整域名
如果你能修改 DNS,优先建立 Domain property(网域资源)。它覆盖该域名下的 HTTP、HTTPS 以及子域名;URL-prefix property(网址前缀资源)只覆盖填写的协议和路径范围。Google 官方的 网站所有权验证说明 会提供 TXT 或 CNAME 记录。
验证完成后,不要急着批量提交网址。先用 URL 检查工具测试首页和一个核心页面的“实际网址”,确认 Google 访问到的是正式页面,而不是缓存、登录页、错误页或测试版本。
站内已有一篇 Google Search Console 安装与使用指南,适合需要完成账号验证和基础配置的团队;本篇继续处理上线后的发现与收录流程。
第 3 步:生成只包含规范网址的 XML Sitemap
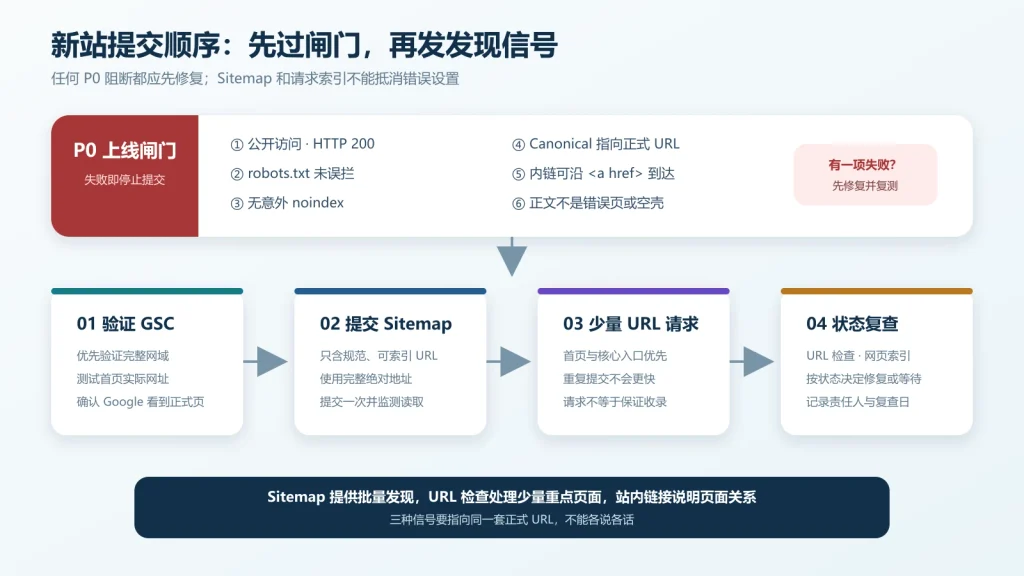
Sitemap 的作用是向 Google 提供一份可发现的网址清单,它是提示,不是收录指令。Google 官方建议在 Sitemap 中放入希望出现在搜索结果里的规范网址,并使用完整的绝对 URL。
上线时至少检查这四点:
- Sitemap 可以在未登录状态下打开,并返回
200; - 只列入正式、可索引、规范的 URL,不放测试页、跳转页、404、筛选参数和
noindex页面; lastmod只在页面内容确实发生重要更新时改变;- 在 Search Console 的“Sitemaps”报告提交 Sitemap,或在
robots.txt中加入Sitemap:行。
Google 说明,单个 Sitemap 的上限是 50 MB(未压缩)或 50,000 个 URL,超过时需要拆分并使用 Sitemap index。大多数新站远达不到这个规模,不必为了“显得完整”生成许多空 Sitemap。具体格式可查看 Google 的 Sitemap 创建与提交文档;WordPress 操作可继续阅读站内的 Sitemap 创建教程。
第 4 步:只为少量核心页面请求编入索引
URL 检查工具适合少量重要网址,例如首页、主产品或服务分类页、关键商业页面。先运行实际网址测试,确认页面可访问,再点击“请求编入索引”。
不要把站内每个 URL 都手工提交,也不要每天重复提交同一页面。Google 明确说明,请求抓取有配额,重复请求不会让抓取更快;抓取通常需要几天到几周,是否最终收录仍由系统判断。页面数量多时,应该依靠 Sitemap 和站内链接,而不是人工点击。参见 Google 的重新抓取说明。
还有一个常见误区:普通网页不能靠 Indexing API“秒收录”。Google 的 Indexing API 文档 目前只支持含 JobPosting 的招聘页面,或在 VideoObject 中嵌入 BroadcastEvent 的直播页面。
第 5 步:让每个重要页面都有可抓取的站内入口
Googlebot 主要通过链接发现新 URL。新站至少应形成这条路径:
首页 → 产品/服务分类页 → 详情页或重点内容页
链接应使用带 href 的标准 <a> 元素。只靠点击后由脚本触发的按钮、站内搜索框或筛选器,可能无法提供稳定的发现路径。Google 的 可抓取链接指南 说明了可识别的链接形式。
把新页面放进 Sitemap,却不从任何导航、分类页或正文链接到它,会形成“孤儿页”。Google 可能知道 URL 存在,却难以判断它在网站中的角色和优先级。对外贸网站而言,首页应链接到主营品类,品类页再链接到重要产品、应用、案例或采购指南。
第 6 步:让核心页面有独立价值,而不是只有一个网址
技术设置正确只能让页面具备被处理的资格。页面如果大量重复供应商文案、只有一张图片和几行参数,或多个城市/语言页面只是替换少量词,即使已经抓取,也可能不被收录。
上线首批页面至少应清楚回答:
- 这页具体提供什么产品、服务或信息;
- 面向谁、适用于什么场景;
- 与站内其他页面有什么实质区别;
- 用户看完能继续做什么,例如查看规格、比较方案、下载资料或提交询盘。
内容不必为了字数变长,但要完成页面承诺。产品页应有真实规格、适用范围和限制;服务页应说明范围、流程与交付;文章应解决一个明确问题。需要更完整的新站内容节奏,可继续看 新站 60 天冷启动指南。
第 7 步:按证据监测,不要只用 site: 指令猜测
site:example.com 可以快速查看部分结果,但 Google 提醒,搜索运算符受到索引和检索限制,不适合作为可靠的诊断工具。判断单个页面时,以 Search Console 的 URL 检查为准;判断整站趋势时,看 Page indexing(网页索引)和 Sitemaps 报告。
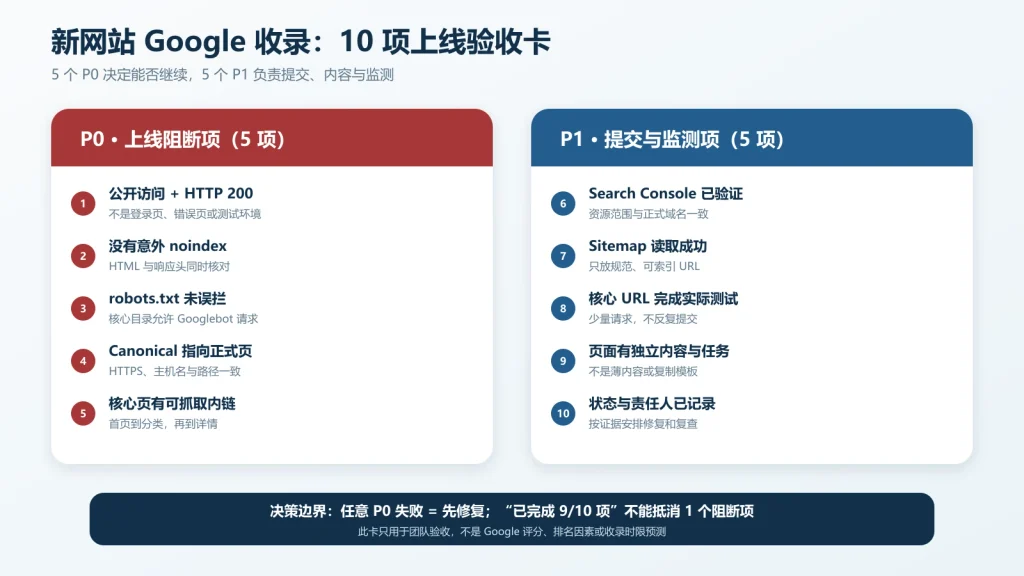
下面是一份上线团队可直接使用的 10 项验收表。数字代表工作优先级,不是 Google 评分,也不是排名因素。
| # | 检查项 | 优先级 | 通过证据 |
|---|---|---|---|
| 1 | 首页和核心页面公开可访问并返回 200 | P0 | 无痕窗口与抓取测试均成功 |
| 2 | 正式站没有全站 noindex 或误拦目录 | P0 | HTML、响应头、URL 检查一致 |
| 3 | robots.txt 未阻止需要收录的核心页面 | P0 | robots 测试和实际抓取通过 |
| 4 | Canonical 指向最终 HTTPS 正式网址 | P0 | 页面源码与 URL 检查一致 |
| 5 | 首页、分类页、核心详情页之间存在 <a href> 链接 | P0 | 抓取工具可沿链接到达 |
| 6 | Search Console 已验证正确资源 | P1 | 资源所有权显示已验证 |
| 7 | Sitemap 只含规范、可索引 URL | P1 | Sitemaps 报告读取成功 |
| 8 | 首页及少量核心 URL 完成实际网址测试 | P1 | URL 检查无访问阻断 |
| 9 | 核心页面有独立正文与明确任务 | P1 | 人工内容审核通过 |
| 10 | 已记录网页索引状态、责任人和复查日期 | P1 | 上线台账可追踪 |
口径:P0 是上线阻断项,任意一项失败都不应继续以“多提交几次”代替修复;P1 是提交与监测项。10 项完成数只用于项目管理,不能预测收录时间。
Search Console 显示未收录时,按状态决定下一步
| 看到的状态或现象 | 更可能卡在哪里 | 下一步 |
|---|---|---|
| URL is unknown to Google | 尚未建立稳定发现路径 | 检查 Sitemap、首页/分类页链接,再测试实际网址 |
| Blocked by robots.txt | 抓取规则阻止访问 | 修改对应规则,确认不是误拦核心目录 |
Excluded by noindex | 页面明确要求不进入索引 | 如果该页应公开,移除 meta 或响应头中的 noindex |
| Page with redirect | 检查的是跳转源 | 核对并检查最终目标 URL;Sitemap 只保留目标 URL |
| Duplicate / Google chose different canonical | 规范信号冲突或内容高度重复 | 统一 canonical、重定向、Sitemap 与内链目标 |
| Discovered – currently not indexed | 已发现但尚未抓取 | 检查服务器稳定性、站内路径和 URL 库规模,再给系统时间 |
| Crawled – currently not indexed | 已抓取但暂未进入索引 | 核对重复内容、页面价值、soft 404 与规范网址,不要只重复提交 |
状态名称会随 Search Console 界面更新,判断逻辑仍应围绕“发现、访问、规范化、内容处理”四层证据展开。Google 说明,多数网站不应期待同日抓取,新页面通常至少需要几天;抓取和收录也可能需要几周。可参考 Google 抓取问题排查指南。
不要用这 5 种“加速方法”替代真正修复
- 每天重复提交同一个 URL。 配额不会变成优先通道。
- 反复删除再提交同一 Sitemap。 Google 会自行重新读取;无变化的文件不必每天提交。
- 给普通网页调用 Indexing API。 超出官方支持范围。
- 购买所谓“秒收录”外链包。 它不能修复
noindex、错误 canonical 或低价值页面,还可能带来垃圾链接风险。 - 只看 site: 搜索数量。 它适合粗略观察,不适合验收单个 URL。
真正可控的是:让页面可访问、信号一致、路径清楚、内容有用,并留下可复查的 Search Console 证据。至于具体抓取和收录时间,任何服务商都无法替 Google 保证。
常见问题
新网站一般多久会被 Google 收录?
没有固定时限。Google 官方给出的范围是抓取可能需要几天到几周,并指出多数普通网站不应期待发布当天就被抓取。先确认没有技术阻断,再观察 URL 检查和网页索引报告;等待本身不等于故障。
提交 Sitemap 后,是否还要逐个请求编入索引?
不需要把所有页面逐个提交。Sitemap 负责批量提供网址,URL 检查适合首页和少量高优先级页面。重复请求同一网址不会让抓取更快,而且存在提交配额。
外链能不能帮助新站更快被发现?
来自真实相关页面的链接可以增加发现路径,但不需要为了收录购买链接。先把首页、分类和详情页的站内链接做好;站外曝光应来自真实合作、目录、媒体或社群内容,而不是批量制造链接。
为什么页面已抓取,仍显示未编入索引?
抓取只表示 Google 读取过页面,不代表一定收录。继续检查页面是否重复、是否像错误页、规范网址是否冲突,以及内容是否完成了明确任务。若没有明显错误,给系统重新处理的时间,不要每天重复提交。
可以用 Indexing API 提交普通产品页和文章吗?
不可以。Google 目前只允许 Indexing API 用于含 JobPosting 的招聘页面,或带 BroadcastEvent 的直播视频页面。普通产品页、服务页和文章仍应使用 Sitemap、站内链接与 Search Console。
FAQ 结构化数据能加快收录吗?
不能。结构化数据应与页面可见内容一致,它不能绕过抓取和索引流程。普通 B2B 文章也不应默认添加 FAQPage;是否适用要以当前 Google 资格说明和站点实际内容为准。
下一步:把“没收录”拆成可修复的问题
如果网站上线后仍有大量核心页面未收录,先导出 URL 清单,逐页记录状态码、robots、noindex、canonical、Sitemap、内链入口和 Search Console 状态。需要外部团队帮助判断问题属于技术设置、页面重复还是内容不足,可以查看 谷歌收录优化服务;如果还无法确定问题范围,可先提交网址做一次 免费 SEO / GEO 初步诊断。
内容勘误或资料核对,请通过联系页告知文章链接和具体问题。